robots.txt richtig einsetzen: Best Practices für SEO
Was die robots.txt steuert und was nicht, wie du sie richtig aufbaust, welche Fehler Sichtbarkeit kosten und wie du KI-Crawler und Prüfung angehst.
Die robots.txt ist eine kleine Textdatei im Hauptverzeichnis deiner Website. Sie sagt Suchmaschinen und anderen Crawlern, also Programmen, die Websites automatisch abrufen, welche Bereiche sie besuchen dürfen. Für die meisten kleinen Websites reicht eine kurze Datei: alles erlauben, unnötige Bereiche wie die interne Suche ausschliessen und den Weg zur Sitemap angeben. Wichtiger als jede einzelne Regel ist, was die Datei nicht kann: Sie entfernt keine Seiten aus Google und sie schützt keine vertraulichen Inhalte. In diesem Artikel erfährst du, wie du die Datei erstellst, welche Regeln sinnvoll sind, welche Fehler Sichtbarkeit kosten und wie du das Ergebnis prüfst.
Das Wichtigste in Kürze
- Die robots.txt steuert das Crawling, also den Abruf von Seiten. Ob eine Seite in den Suchergebnissen erscheint, steuerst du mit noindex oder einem Passwortschutz.
- Die Datei heisst genau
robots.txt, ist UTF-8-codiert und liegt im Hauptverzeichnis, zum Beispiel unterhttps://www.beispiel.ch/robots.txt. - Blockiere nie Seiten, CSS- oder JavaScript-Dateien, die Google für die Darstellung deiner wichtigen Seiten braucht.
- Der teuerste Fehler ist
Disallow: /nach einem Relaunch: Damit sperrst du die ganze Website. - Prüfe jede Änderung im robots.txt-Bericht der Google Search Console und mit der URL-Prüfung.
Was die robots.txt steuert und was nicht
Google beschreibt den Zweck der Datei klar: Mit ihr teilst du Crawlern mit, auf welche URLs sie zugreifen dürfen. Sie dient vor allem dazu, den Crawling-Verkehr zu steuern und deinen Server nicht mit Anfragen zu überlasten.
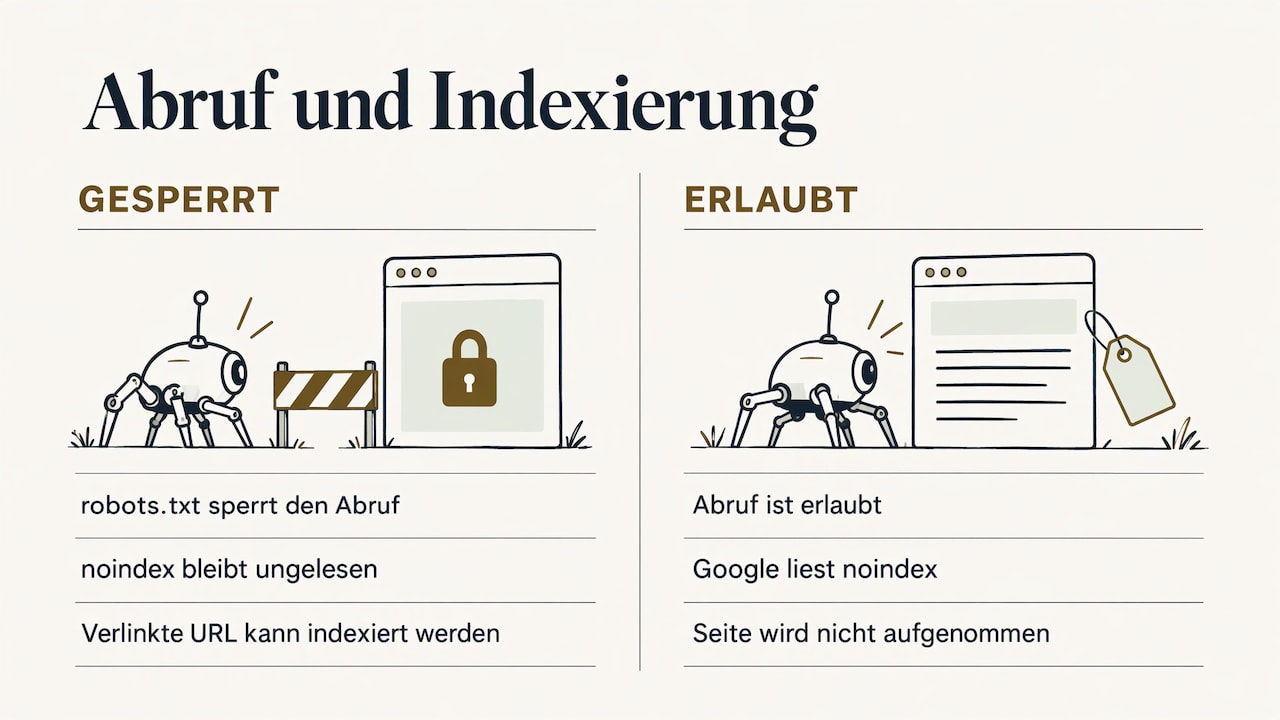
Für SEO ist eine Unterscheidung zentral: Crawling und Indexierung sind zwei verschiedene Dinge. Crawling heisst, dass Google eine Seite abruft. Indexierung heisst, dass Google sie in sein Verzeichnis aufnimmt und in den Suchergebnissen zeigen kann. Google trennt in seinen Prüfwerkzeugen ausdrücklich zwischen «Crawling erlaubt?» und «Indexierung erlaubt?».
Die robots.txt wirkt nur auf das Crawling. Eine Seite, die du per robots.txt sperrst, kann trotzdem in Google auftauchen, wenn andere Seiten auf sie verlinken. Das Suchergebnis erscheint dann ohne Beschreibung, weil Google den Inhalt nie lesen durfte. Wer eine Seite aus der Suche heraushalten will, braucht deshalb noindex: eine Anweisung im Code der Seite oder im HTTP-Header, die Suchmaschinen sagt, die Seite nicht in den Index aufzunehmen. Alternativ schützt du die Seite mit einem Passwort.
Daraus folgt eine Regel, die viele übersehen: Damit Google ein noindex überhaupt sieht, muss es die Seite abrufen dürfen. Sperrst du dieselbe Seite zusätzlich per robots.txt, bleibt das noindex ungelesen.
So ist eine robots.txt aufgebaut
Die Datei ist reiner Text ohne Formatierung. Laut Google besteht sie aus einer oder mehreren Regelgruppen. Jede Gruppe beginnt mit User-agent, dem Namen des Crawlers, für den die Regeln gelten. Darunter folgt pro Zeile eine Regel.
Die wichtigsten Anweisungen:
| Anweisung | Was sie bewirkt | Beispiel |
|---|---|---|
User-agent |
Nennt den Crawler, für den die Gruppe gilt. * steht für alle. |
User-agent: * |
Disallow |
Sperrt einen Pfad für das Crawling. | Disallow: /suche |
Allow |
Erlaubt einen engeren Pfad innerhalb eines gesperrten Bereichs. | Allow: /downloads/preisliste.pdf |
Sitemap |
Zeigt den Weg zur XML-Sitemap, einer Liste aller wichtigen Seiten. | Sitemap: https://www.beispiel.ch/sitemap.xml |
Pfade beginnen immer mit einem Schrägstrich / und gelten als Anfang einer Adresse. Disallow: /suche sperrt also /suche, /suche?q=velo und auch /suchergebnisse. Willst du nur ein Verzeichnis sperren, schreibst du den Schrägstrich am Ende: Disallow: /suche/.
Eine typische Datei für die Website eines Schreinerbetriebs oder einer Physiotherapie-Praxis sieht so aus:
User-agent: *
Disallow: /suche
Disallow: /danke

Sitemap: https://www.beispiel.ch/sitemap.xml
Das bedeutet: Alle Crawler dürfen alles, ausser der internen Suche und der Dankesseite nach dem Absenden eines Formulars. Beide Seiten haben für Suchende keinen Wert.
Bei der Sitemap-Zeile ist Google streng: Die Adresse muss vollständig angegeben sein, also mit https:// und der genauen Domain. Google probiert keine Varianten mit oder ohne www oder mit http aus.
robots.txt erstellen: Schritt für Schritt
Du brauchst kein Programm und kein technisches Wissen. Diese Schritte reichen:
- Überlege, was gesperrt werden soll. Bei den meisten kleinen Websites ist das wenig: interne Suche, Dankesseiten, eventuell Filter- oder Sortierseiten. Alles andere bleibt offen.
- Erstelle die Datei. Sie muss genau
robots.txtheissen, in Kleinbuchstaben. Google verlangt eine UTF-8-Codierung, das ist der heute übliche Standard für Textdateien. - Schreibe die Regeln. Starte mit
User-agent: *, ergänze deineDisallow-Zeilen und am Schluss die Sitemap-Zeile. - Lade sie ins Hauptverzeichnis. Die Datei gehört direkt unter deine Domain, also
https://www.beispiel.ch/robots.txt. In einem Unterordner wie/seiten/robots.txtbeachtet sie niemand. Pro Host, also pro Domain oder Subdomain, gibt es genau eine Datei. - Ruf die Adresse im Browser auf. Siehst du deinen Text, ist die Datei erreichbar.
- Prüfe sie bei Google. Wie das geht, steht weiter unten im Abschnitt zum Testen.
Baust du deine Website mit einem KI-Assistenten wie Claude oder ChatGPT, ist das ein typischer Auftrag im Gespräch. Du kannst etwa schreiben: «Erstelle eine robots.txt, die alles erlaubt ausser /suche und /danke, und füge die Sitemap unter https://www.beispiel.ch/sitemap.xml hinzu.» Lass dir danach jede Zeile in einem Satz erklären. So weisst du, was in deiner Datei steht. Wie das konkret abläuft, zeigen Website mit Claude erstellen und Website mit ChatGPT erstellen.
Und brauchst du überhaupt eine robots.txt? Streng genommen nicht. Fehlt die Datei, meldet der Server den Fehler 404 «nicht gefunden». Google stuft das als nicht gravierend ein und crawlt dann einfach alle URLs. Eine kurze Datei mit Sitemap-Zeile ist trotzdem sinnvoll: Sie zeigt Crawlern den direkten Weg zu deinen wichtigen Seiten.
Best Practices für eine saubere Datei
Aus den Vorgaben von Google und der Praxis kleiner Websites ergeben sich diese Grundsätze:
- So kurz wie möglich. Jede Regel ist eine mögliche Fehlerquelle. Eine Website mit 20 Seiten braucht selten mehr als fünf Zeilen.
- Wichtige Ressourcen offen lassen. Google rendert deine Seiten, es baut sie also wie ein Browser auf. Dafür braucht es Zugriff auf CSS-, JavaScript- und Bilddateien. Google verlangt, dass Seiten und Ressourcen, die gecrawlt werden sollen, nicht durch robots.txt blockiert sind.
- Seiten ohne Wert für Suchende ausschliessen. Dazu gehören interne Suchergebnisse, Dankesseiten, Warenkorb- oder Kontoseiten und Adressen mit Sortier- oder Tracking-Zusätzen. So verschwenden Crawler ihre Zeit nicht mit Seiten, die doch niemand über Google finden soll.
- Mit Mustern statt Einzelregeln arbeiten. Suchmaschinen verarbeiten Dateien über 500 KiB möglicherweise nur teilweise. Ein breiteres Muster ersetzt oft Dutzende einzelne Zeilen.
- Sitemap angeben. Die Sitemap-Zeile ist der einfachste Weg, Crawlern deine wichtigen Seiten zu zeigen. Halte die Sitemap aktuell, wenn du Seiten hinzufügst oder entfernst. Wie das geht, steht im Beitrag Sitemap pflegen.
- Kommentare nutzen. Zeilen, die mit
#beginnen, ignorieren Crawler. Schreib dir so auf, warum eine Regel existiert, etwa# interne Suche, keine Inhalte. - Gross- und Kleinschreibung beachten. Pfade sind in der robots.txt nicht beliebig:
/Sucheund/suchesind zwei verschiedene Adressen.
Viele ähnliche Adressen, etwa durch Filter, Sortierungen oder Kalenderansichten, kosten nicht nur Crawling-Zeit, sondern belasten auch den Server. Wie Ladezeit und überflüssige Anfragen zusammenhängen, zeigt ein Überblick zur Performance-Optimierung von Websites mit den wirksamsten Hebeln.
Häufige Fehler, die Sichtbarkeit kosten
Die ganze Website gesperrt
Diese zwei Zeilen sperren alles für alle Crawler:
User-agent: *
Disallow: /
Auf einer Testumgebung ist das gewollt. Gefährlich wird es, wenn die Datei nach einem Relaunch, also einer Neugestaltung der Website, unverändert auf die Live-Website kommt (mehr dazu im Beitrag Website-Relaunch und SEO). Dann ruft Google keine einzige Seite mehr ab. Kontrolliere die robots.txt deshalb bei jedem Umzug und jeder neuen Version als Erstes.
Zu breite Muster
Das Sternchen * steht für beliebige Zeichen. Disallow: /*? sperrt jede Adresse mit Fragezeichen. Das trifft Tracking-Zusätze, aber womöglich auch Seiten, die du in Google sehen willst, etwa eine Produktseite mit ?farbe=rot. Teste Muster immer an echten Adressen deiner Website, bevor du sie veröffentlichst.
robots.txt statt noindex
Google warnt ausdrücklich davor, die Datei zu nutzen, um Seiten vor der Google-Suche zu verbergen, PDFs eingeschlossen. Verlinken andere Seiten darauf, kann Google die Adresse trotzdem indexieren. Für das Entfernen aus der Suche ist noindex das richtige Mittel.
Vertrauliches über die robots.txt «verstecken»
Die Datei ist öffentlich. Jede Person kann sie unter /robots.txt lesen. Das Mozilla Developer Network weist darauf hin, dass Angreifer so die Standorte sensibler Pfade erfahren können. Zudem halten sich schädliche Bots, etwa Programme, die E-Mail-Adressen sammeln, ohnehin nicht an die Regeln. Eine Zeile wie Disallow: /kundendaten/ ist also eine Wegbeschreibung, kein Schloss. Vertrauliches gehört hinter einen Passwortschutz oder gar nicht auf den Webserver.
Serverfehler bei der robots.txt
Antwortet dein Server beim Abruf der Datei mit einem Fehler der 500er-Reihe, wissen Suchmaschinen nicht, was sie crawlen dürfen. Laut der Dokumentation zu Google Lighthouse kann das dazu führen, dass sie das Crawling der ganzen Website beenden. Eine fehlende Datei (404) ist harmlos, eine fehlerhafte Serverantwort nicht.
KI-Crawler: Regeln für neue Besucher
Neben Suchmaschinen rufen heute auch Crawler von KI-Anbietern Websites ab, etwa um Sprachmodelle zu trainieren oder Antworten mit aktuellen Quellen zu belegen. Viele davon beachten die robots.txt und lassen sich über ihren eigenen User-agent ansprechen. Die Namen veröffentlichen die Anbieter in ihrer Dokumentation.
Eine Gruppe für einen bestimmten Crawler sieht so aus:
User-agent: GPTBot
Disallow: /

User-agent: *
Disallow: /suche
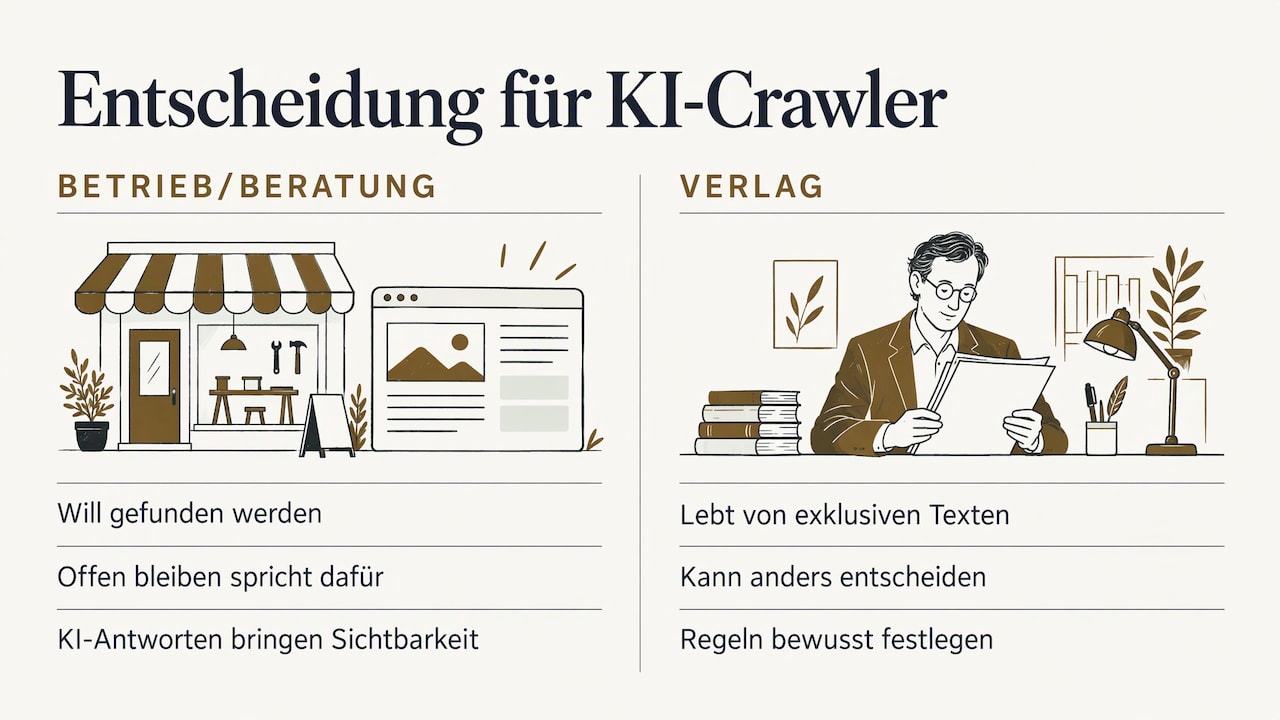
GPTBot ist der Crawler von OpenAI. Hier gilt die Sperre nur für ihn, alle anderen folgen der zweiten Gruppe. Ob du KI-Crawler zulässt, ist eine geschäftliche Entscheidung. Für einen Handwerksbetrieb oder eine Beratung, die gefunden werden will, spricht viel dafür, offen zu bleiben: Wer in KI-Antworten genannt wird, gewinnt Sichtbarkeit. Ein Verlag, der von exklusiven Texten lebt, entscheidet vielleicht anders. Wichtig ist nur, dass du die Entscheidung bewusst triffst und nicht versehentlich mit einer zu breiten Regel.
So testest du deine robots.txt
Google bietet zwei Werkzeuge in der kostenlosen Search Console, dem Verwaltungsbereich für Website-Betreiber:
- Der robots.txt-Bericht zeigt, ob Google deine Datei abrufen und verarbeiten kann, wann sie zuletzt geladen wurde und ob es Warnungen gibt.
- Die URL-Prüfung testet eine einzelne Live-Adresse. Du siehst, ob das Crawling erlaubt ist, und kannst dir die gerenderte Seite ansehen, also so, wie Google sie aufbaut. Fehlen dort Bilder oder sieht das Layout zerbrochen aus, blockiert die robots.txt vermutlich eine Ressource.
Zusätzlich lohnt ein Blick auf den HTTP-Status, die Antwort des Servers beim Abruf. Lighthouse empfiehlt, ihn in den Entwicklertools von Chrome zu prüfen. Steht dort 200, ist alles in Ordnung.
Prüfe nach jeder Änderung drei bis vier deiner wichtigsten Seiten: Startseite, eine Angebotsseite, die Kontaktseite und einen Blogartikel. Ist das Crawling bei allen erlaubt, sitzt die Datei.
So ist es bei MADLAB // Publishing
Bei MADLAB // Publishing ist Claude oder ChatGPT dein Redaktor: Der Assistent baut und ändert die Website im Gespräch. Wir veröffentlichen, hosten und verwalten sie, mit Vorschau, Versionen und Zurückholen. Für die robots.txt heisst das:
- Eine kurze Datei von Anfang an. Unser Leitfaden für den Assistenten sieht für jede Website eine robots.txt vor, die alles erlaubt und auf die
sitemap.xmlzeigt, dazu eine Sitemap mit allen Seiten. Für KI-Assistenten kommt einellms.txtdazu: eine kurze Beschreibung in Markdown, wer die Website betreibt und welche Seiten wichtig sind. - Kein
Disallow: /für die Testumgebung. Die Vorschau ist für Suchmaschinen gesperrt, ohne dass du dafür die robots.txt anfassen musst. Damit fällt der teuerste Fehler weg: eine Sperre aus der Testumgebung, die beim Veröffentlichen mitwandert. - Jede Änderung ist eine Version. Die robots.txt ist eine Datei wie jede andere deiner Website. Ändert der Assistent sie, entsteht eine neue Version mit Zeitpunkt und Autor. Sperrt eine neue Regel zu viel, holst du den vorherigen Stand zurück. Siehe Versionen und Zurückrollen.
- Erst prüfen, dann live. Vor dem Veröffentlichen zeigt dir der Assistent im Probelauf, welche Dateien übertragen werden, die robots.txt eingeschlossen.
Ziehst du von WordPress, Wix oder einem anderen System um, startest du so mit einer sauberen, kurzen Datei statt mit Regeln, die Plugins über die Jahre hinterlassen haben. Wie die Übernahme abläuft, zeigt Bestehende Website übernehmen. Was die Pläne kosten, steht unter Pläne und Zusatzpakete.
Quellen
- Google Search Central: Einführung und Leitfaden zu robots.txt-Dateien
- Google: robots.txt-Datei erstellen und einreichen
- Google Search Console-Hilfe: Check if a URL or image is available to Google
- Google Search Console-Hilfe: Bericht zur robots.txt
- Google Search Central: Technische SEO-Grundlagen
- Chrome for Developers: robots.txt ist ungültig (Lighthouse)
- MDN: robots.txt-Konfiguration (Security)
Häufige Fragen
Wo finde ich die robots.txt meiner Website?
Gib deine Domain im Browser ein und hänge /robots.txt an, zum Beispiel https://www.beispiel.ch/robots.txt. Erscheint Text, existiert die Datei. Erscheint eine Fehlerseite, hast du noch keine, und Google crawlt alle Seiten.
Verbessert eine robots.txt mein Google-Ranking?
Nicht direkt. Sie hilft Google, die Zeit beim Crawlen auf deine wichtigen Seiten zu lenken, und zeigt den Weg zur Sitemap. Eine fehlerhafte Datei kann deinem Ranking aber stark schaden, etwa wenn sie wichtige Seiten oder CSS-Dateien sperrt.
Wie entferne ich eine Seite aus den Google-Suchergebnissen?
Mit noindex im Code der Seite oder mit einem Passwortschutz, nicht mit der robots.txt. Wichtig: Die Seite muss für Google abrufbar bleiben, damit das noindex gelesen wird. Erst wenn sie aus dem Index verschwunden ist, kannst du sie bei Bedarf zusätzlich sperren.
Wie oft sollte ich die robots.txt überprüfen?
Nach jeder grösseren Änderung an der Website, nach einem Relaunch und nach jedem Umzug. Ansonsten reicht ein kurzer Blick in den robots.txt-Bericht der Search Console alle paar Monate. Achte dabei vor allem auf Warnungen und auf die Zeile Disallow: /.
Gilt für die robots.txt das Datenschutzrecht?
Die Datei selbst enthält in der Regel keine Personendaten und fällt damit kaum unter das Schweizer Datenschutzgesetz (DSG). Sie ist aber kein Datenschutzwerkzeug: Personendaten schützt du mit Zugangsbeschränkungen, nicht mit Crawler-Regeln. Das ist allgemeine Information, keine Rechtsberatung.